Ling‑3.0‑flash‑Fin:面向金融投研工作流的开放模型
2026年9月4日,Ling-3.0-flash-Fin模型权重率先在Hugging Face与ModelScope开放获取[1];9月9日,蚂蚁百灵于外滩大会正式发布面向真实金融投研工作流的专用模型Ling‑3.0‑flash‑Fin[2],并同步推出全新金融专业评测基准FinFIRST[3]。该模型摒弃通用大模型的泛化设计思路,垂直聚焦投研链路,覆盖信息检索、研究推理、估值建模、研报生成四大核心环节[4],主打可溯源、可复核[3]、适配真实工作流的金融专业能力,区别于通用模型的泛化问答能力。
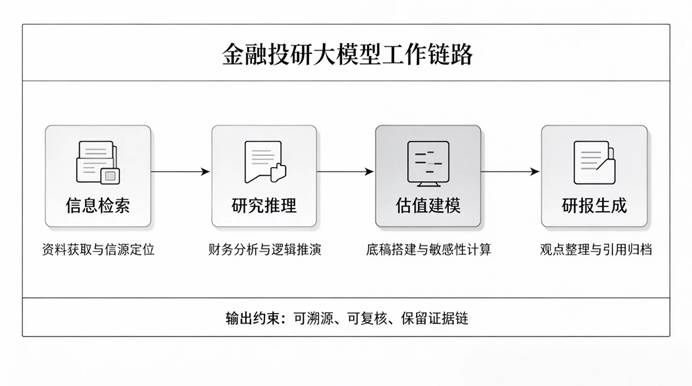
图 1 Ling‑3.0‑flash‑Fin 投研工作链示意图
一、FinFIRST:流程化、原子化的金融评测体系
过往传统金融评测普遍采用答案比对、选择题打分的简单模式,只看最终结果、不校验推理过程,存在明显局限性[5]。通用大模型最常见的问题并非显性计算错误,而是季报年报混淆、财务口径误用等隐性取数错误。这类问题不会暴露在最终答案中,却会造成研报、估值底稿的实质性偏差,出现结果正确但流程错误的行业通病。
FinFIRST的推出正是为了解决这一痛点,通过三层原子化评分机制实现全流程错误溯源。第一层校验原始数据准确性,核查标的主体、报告期、单位、统计口径与数据版本;第二层核验信源质量,判断资料权威性、时效匹配度与一手属性;第三层验证推导逻辑,确保计算步骤、研究结论具备完整可查的证据链。同时,该基准引入UCR(Unsupported-Correct Rate,答案正确但证据链不完整率)指标,专门量化结果正确但证据链残缺的问题[1]。相关金融智能体研究也佐证了这一思路,金融AI的核心瓶颈不在于基础金融认知,而在于长流程任务的状态追踪与稳定逻辑推理,仅靠结果打分无法真实反映模型实战能力[5]。
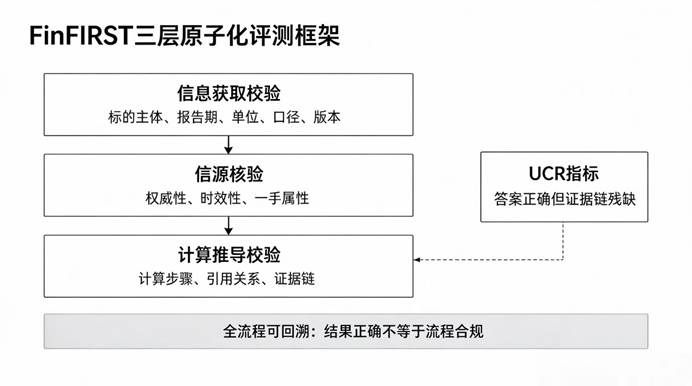
图 2 FinFIRST 评测机制示意图
据官方披露,FinFIRST V1包含123道专家级投研任务[1],拆解为701个原子评分项、12300个评分点[1],题目筛选率仅9.78%[1],题库质量严苛。整体题库实战属性极强,超八成题目含多重子问题,超六成需要显性列式计算,超75%[1]不预设信源,要求模型自主检索甄别。该题库由蚂蚁集团搭建,中金投行团队提供专业支持,多名金融从业者参与出题与质检,完全对标一线投研作业标准[1]。
二、模型架构、训练能力与技术优势
Ling‑3.0‑flash‑Fin采用Ling‑3.0[2]系列成熟的混合专家(MoE)架构,总参数1240亿[4],单token仅激活51亿参数[4],搭配256K[4]超长上下文窗口,兼顾大模型专业知识储备与轻量化部署优势。大参数量保障模型承载海量金融专业语料,适配复杂的投研场景;小激活参数能有效降低推理成本,支持金融机构私有本地化部署,无需依赖云端调用,适配批量长文档处理需求。训练层面,模型采用“海量金融语料预训练+金融领域对齐+场景微调”三阶段路径,先依托海量年报、研报、财报与行业文本完成持续预训练,再联合头部金融机构完成场景微调。实测结果显示,专业化迭代并未牺牲通用能力,模型在AA Intelligence Index v4.1.1基准中,得分从基座38分提升至41分[3],实现通用能力与金融专业能力双向升级,具备规模化落地生产环境的条件。
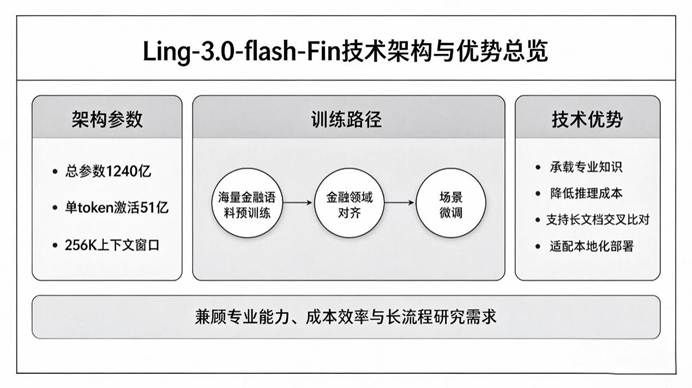
图 3 Ling‑3.0‑flash‑Fin 技术架构示意图
三、落地应用场景与产业实践
在真实投研落地中,Ling‑3.0‑flash‑Fin可覆盖四大高频刚需场景,大幅降低研究员基础工作负担。一是研报数据批量核对,可导入多家企业历年财报,统一统计口径,自动输出毛利率、应收账款周转率等核心指标对比表,逐条标注数据出处与报告期;二是估值底稿快速搭建,基于业务假设与历史财务数据,自动生成DCF与相对估值初稿,完整保留计算公式与标注口径并输出敏感性分析;三是多信源冲突校验,针对同一指标在不同研报中的表述差异,自动拆解报告期变更、口径调整、会计优化等差异成因;四是行业文献综述,围绕指定选题结构化梳理近三年研报、论文与监管文件,输出观点、证据、来源清晰的写作提纲[3]。目前,熵简科技已将该模型接入AlphaClaw投研平台[6],落地应用于AI硬件产业链需求测算、产品配置对比、专家访谈提纲设计等实战场景,产业化效果得到验证。
四、模型使用边界与现存局限
即使Ling‑3.0‑flash‑Fin具备覆盖投研多环节的技术能力,但也仅是一个投研辅助工具。FinFIRST评测中Strict Pass与Loose Pass的明显差距[1],直接证明模型普遍存在证据链残缺、溯源不完整的问题,必须依靠人工终审把关。现阶段模型仍存在一些短板:评测结果基于厂商自研框架,尚未完成大规模第三方独立复测[5];123道评测题目覆盖场景有限,暂无法成为行业通用验收标准;同时模型训练存在时间截止点,检索信源排序稳定性不足,财报季密集公告期更易出现取数失误。此外,金融AI权责归属机制尚未完善,AI底稿出错仍由签字分析师担责,模型厂商与部署方无明确责任[7],这也导致金融机构大规模商用仍保持观望。
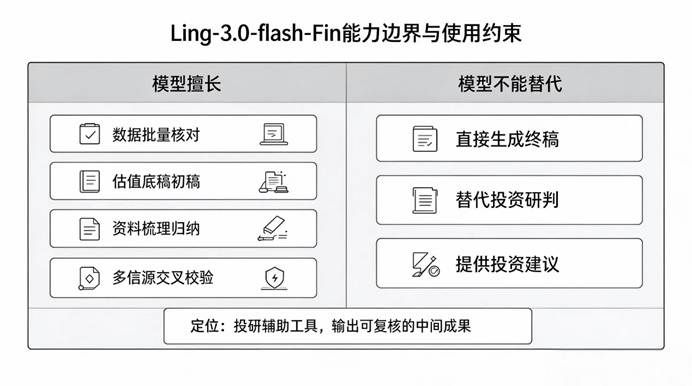
图 4 Ling‑3.0‑flash‑Fin 边界示意图
五、对金融AI研究与实务的启示
FinFIRST的原子化评测思路,为金融AI行业提供了全新迭代方向,摆脱了以往的唯结果论[5],将评测重心转移至取数、信源、计算全流程校验。这种白盒化能力,不是简单增加解释文本,而是固定整条推理证据链的每一个节点,实现全链路可回溯。对机构而言,可依托该思路,结合授信材料核对、公告综述、投研数据清洗等真实业务,搭建私有评测题库[3],持续打磨适配业务的专属AI能力。长远来看,模型算法与算力终将被追赶,但贴合真实场景的评测标准制定权,才是金融AI的核心长期壁垒。对从业者而言,无需局限于运用大模型问答的浅层用法,能帮助减少日常多工具切换、重复整理的低效流程,让模型承接资料搜集、口径对齐、数据整理、引用归档等基础工作,结合个人投研流程灵活嵌入,最大化释放工具价值。
六、总结
真实金融业务对严谨性、可追溯性有着极高要求,Ling‑3.0‑flash‑Fin和FinFIRST的价值,就在于把模型能力约束到可核验的范围之内[1]。作为一类新兴的行业技术样本,它也值得在后续的研究工作中进一步观察与审视。它并不替代人的专业判断,而是完成投研链条中大量机械繁琐的基础性工作,通过技术减负优化业务流程,为金融更好服务实体经济、落地普惠金融业务提供新的实践思路,也为推进金融强国建设贡献来自金融AI领域的参考价值。
参考文献
[1] 蚂蚁开源. 开放模型 开放评测:Ling-3.0-flash-Fin与FinFIRST正式开源[EB/OL]. (2026-09-04)[2026-09-30]. 微信公众号.
[2] Ant Group. Ant Group Open-Sources Ling-3.0-flash-Fin for Real-World Financial Workflows[EB/OL]. (2026-09-09)[2026-09-30]. https://www.antgroup.com/en/news-media/press-releases/1788944400000.
[3] inclusionAI. FinFIRST: Financial Information Retrieval, Sourcing and Traceability[DS/OL]. (2026-09)[2026-09-30]. https://www.modelscope.cn/datasets/inclusionAI/FinFIRST.
[4] BlockBeats. 蚂蚁百灵金融模型正式开源:MIT许可,123道金融搜索题发布[EB/OL]. (2026-09-04)[2026-09-30].
[5] Anonymous. Herculean: An Agentic Benchmark for Financial Intelligence[J/OL]. (2026-05-29)[2026-09-30].
[6] 熵简科技. AlphaClaw接入Ling-3.0-flash-Fin技术解析[EB/OL]. (2026-09-15)[2026-09-30]. 微信公众号.
[7] 中国信息通信研究院. 企业级智能体技术与应用研究报告(2026年)[R]. 北京: 中国信息通信研究院, 2026.