BloombergGPT:七千亿token训练出的金融大模型
当ChatGPT出圈后,大模型也快速进入了金融领域,但通用大模型在金融业的缺陷也随之暴露。仅仅依托公开网页语料训练,通用大模型缺乏金融认知,面对专业词汇,仅能识别字面含义,无法理解金融场景下的意义及逻辑。并且,网络上多为二手碎片化信息,缺乏金融终端一线真实数据,通用大模型无法习得市场真实运行规律,难以适配专业金融场景。在此背景下,彭博联合约翰霍普金斯大学,于2023年3月推出垂直金融大模型BloombergGPT。该模型参数规模506亿,采用Decoder-only架构,依托超7000亿token海量语料训练,精准适配金融各类专业任务。
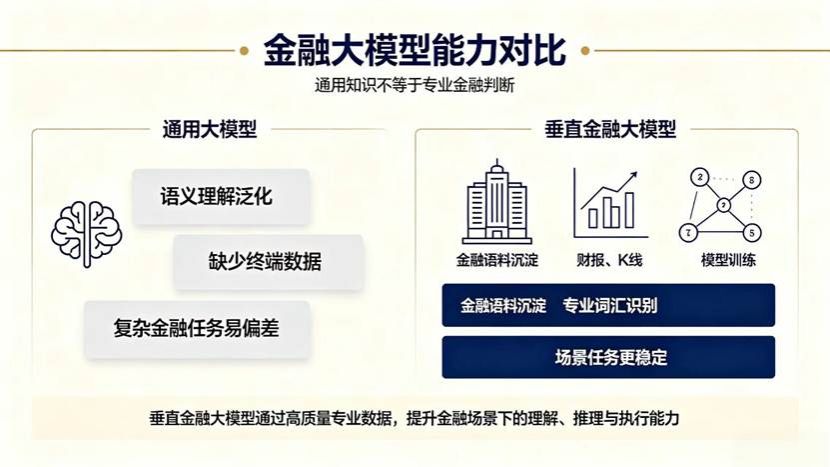
图 1 通用大模型与垂直金融大模型对比图
一、核心功能
BloombergGPT的核心价值,是用实测数据打破了参数决定模型的固有认知。在金融专项任务中,ConvFinQA金融问答准确率达43.41%,远超同规模通用模型GPT-NeoX的30.06%;FiQA金融情感分析F1值为75.07%,大幅领先后者的50.59%。凭借三千多亿token的专业金融语料积累,500亿级别的BloombergGPT相较通用大模型在金融领域具有更为出色的表现。同时模型采用通用与金融语料混合训练模式,有效规避了垂直训练导致的通用推理退化等问题,兼顾了专业精度与基础推理能力。
二、训练体系
BloombergGPT优异性能的背后,是一套精细化的训练体系。模型整体训练语料超7000亿token,采用接近1:1的黄金配比,兼顾专业性与通用性。其中3630亿token来自彭博自研FinPile金融语料库,汇总了2007至2022年十五年间的独家核心资源,涵盖金融新闻、上市公司财报、监管文件等一线终端数据,且经过去重、清洗等多轮处理,数据质量远超公开语料。剩余3450亿token取自通用开源语料,经过多组消融实验验证,51:49的金融与通用语料配比为最优方案,平衡了垂直任务能力与通用基础素养。
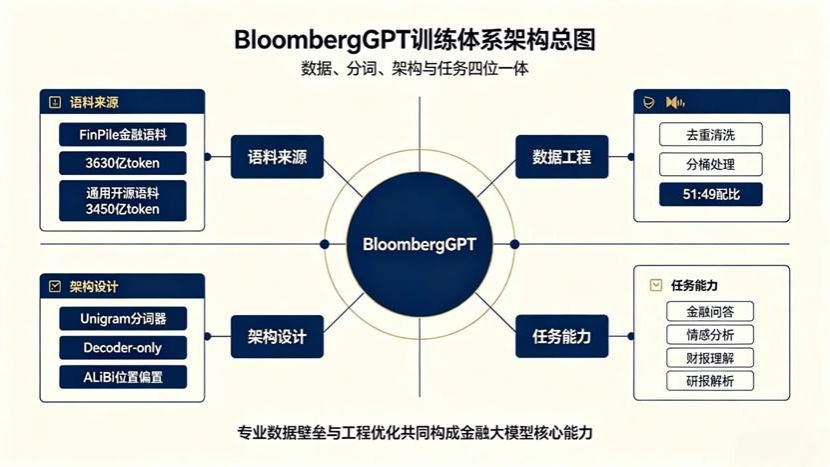
图 2 BloombergGPT体系架构图
三、细节架构:分词与模型适配优化
分词器的定制优化是模型的核心优势。BloombergGPT放弃传统BPE分词模式,自研Unigram分词器4,将词表扩容至131072,支持空格入词,可将完整金融短语或专业指标直接识别为独立token。相较主流分词模型,其金融语料压缩率提升9%,同等上下文窗口可容纳更长的财报等文本,大幅提升长金融文档处理效率。在架构层面,模型沿用成熟Decoder-only架构2,搭配ALiBi位置偏置技术,支持长文本外推解读,可完整解析百页级金融文档无需截断3。同时参数规模严格适配算力标准,以最优参数密度完成训练,通过交替推送两类训练数据,有效规避模型遗忘问题。
四、局限性
虽然BloombergGPT作为金融垂类大模型的开山之作,但仍存在一些局限性。其一,模型权重与FinPile语料均未开源,仅限在彭博终端内调用;其二,行业优势持续弱化,随着GPT-4级通用模型垂直适配能力升级,以及FinGPT等轻量化开源金融模型崛起,其多项核心任务优势已被追平甚至反超;其三,结构性缺陷受架构与分词机制限制,数值推演精度不足,面对金融复杂计算场景可靠性较差。这种闭源的策略在构建初期数据壁垒的同时,使得其在面对快速演进的通用模型与开源生态上,限制了模型的迭代频率。
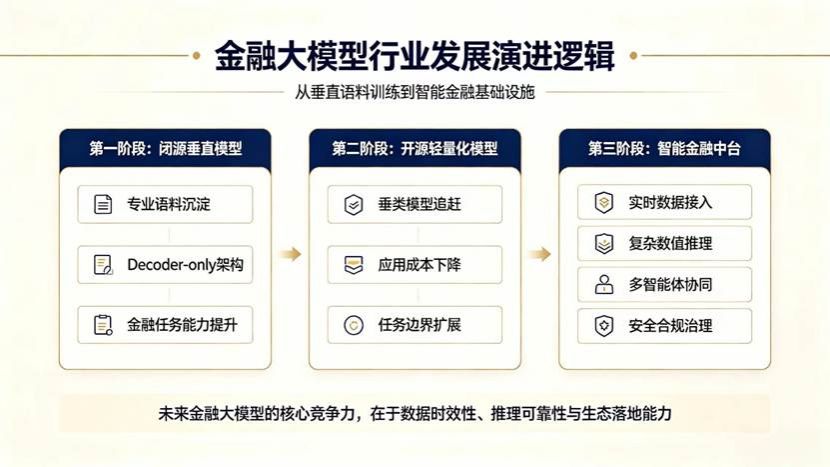
图 3 金融大模型行业发展演进图
五、结语
整体来看,BloombergGPT验证了垂直大模型的路径可行性,也揭示了数据主权与时效性的核心挑战。在自主可控成为行业共识的今天,探索兼顾安全与效能的国产化技术路线,对于未来构建普惠金融具有长远价值。
1. Wu S, Irsoy O, Lu S, Dabravolski V, Dredze M, Gehrmann S, Kambadur P, Rosenberg D, Mann G. BloombergGPT: A Large Language Model for Finance[EB/OL]. (2023-03-30)[2026-08-05].
2. LE SCao T, FAN A, AKiki C, et al. BLOOM: A 176B-Parameter Open-Access Multilingual Language Model[EB/OL]. (2022-11-09)[2026-08-05].
3. PRESS O, SMITH N A, LEWIS M. Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation[EB/OL]. (2021-08-27)[2026-08-05].
4. KUDO T. Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates[C]//Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers). Melbourne: Association for Computational Linguistics, 2018: 66-75. DOI: 10.18653/v1/P18-1007.
5. LIU X, KONG Y, DONG X, et al. A Survey of Large Language Models for Financial Applications: Progress, Prospects and Challenges[EB/OL]. (2024-06-15)[2026-08-05].
6. YANG H, LIU X, WANG C D. FinGPT: Open-Source Financial Large Language Models[EB/OL]. (2023-06-09)[2026-08-05].